ئۇيغۇرچە
10-24 更新 · 观察窗口 10-03—10-24 · 实际选用指南

「斩杀线」之下
大模型,按任务选
Opus 5.5 · Kimi K3.1 Pro · GPT-6.1 Sol · Gemini 4 Argon
DeepSeek 1017 · Haiku 5.5 · MiMo V2.6

中文长稿与前端/3D 创作,新增 K3.1 Pro 试产候选;写作仍以 Opus 4.6 为基准、Opus 5.5 做挑战者;做工程默认 Sol 6.1,新候选试 Argon;压低批量成本,Haiku 5.5、DeepSeek 1017 与 MiMo 同场试。 Sonnet 5.5 管日常交付。K3、GLM 已跑通的流程继续保留,用合格交付率和人工修改时间决定是否真正迁移。

2026-10-24 核查 · 官方费率 / AA 当前快照 / 公开试用 · 选型建议不等于本项目实测

0.72$/task
GPT-6.1 Sol max · AA 当前快照 52 分 / $0.72;复杂工程的高性价比默认候选,不是你业务的完成率。
55分
Kimi K3.1 Pro · AA 55 分 / $2.11,全球第四;开放权重 11-04 前发布,发布首日不作生产默认。
20个任务
迁移前先跑同一批真实任务:统计通过率、总成本和人工介入时间,再扩大新模型流量。
01

最近三周,哪些变化值得换模型

观察窗口:2026-10-03 至 2026-10-24。只把已核实发布、可用入口和会改变交付成本的变化放进时间线;不是见到新名字就换主力。

10-24
Kimi K3.1 Pro:长稿与 Agent 双候选
凌晨发布,1M 上下文,API $2/$10(Highspeed $4/$20)。AA 55 分排全球第四;官方 Terminal-Bench 4.0 65.7%,接近 Opus 5.5 的 66.4%;GDPval-AA Elo 1846 第三。开放权重 11-04 前发布。新任务试 K3.1 Pro,已有 K3 流程不强拆。 Kimi · AA
10-06
Mistral Large 4 公开预览
促销价 $0.68/$2.09(刊例 $1.36/$4.18),官方宣布月末公开权重。先放观察名单;权重未落地前不当作可私有化部署的现货。 Mistral价格
10-07
Claude Haiku 5.5:低价高速新候选
≤100K 提示 $0.10/$0.50,AA max 43 分 / $0.21 task / 235 tok/s。同日 Sonnet 5.5 缓存读降至 $0.10。批量与快反任务多一个强候选。 Haiku · Claude价格 · AA
10-08
Sol 6.1 Ultrafast 上线
官方新增更快计费档;不要把 Ultrafast 的账单套进 Standard 价格比较。本文一律用 Standard 口径。 OpenAI更新
10-12
Muse Wonder / Wonder Full 发布
Wonder API $4/$20、缓存 $0.20;Full 仅限订阅、无公开 API 价,两者不能混用价格。AA 快照 Wonder max 52 分 / $4.54 task。 Muse价格 · AA
10-13
Gemini 4 Argon 正式开放
AI Studio 与 API 可用;导入价 $2/$10 到 11-30,之后 $4/$20。移出受限观察,进入复杂代码与多模态候选。 Argon · Google价格
10-17
DeepSeek V4.1 Flash 1017:重回前排
deepseek-flash 现由 1017 版本服务,费率不变;AA max 升至 45 分 / $0.26 task / 195 tok/s。Search 与 Fetch 各 $0.75/千次,11-01 起计费(此前经 Harness/Claude Code/Codex 免费)。 DeepSeek · AA
10-23 复核
撤回两条旧结论
Sonnet 5.5 max 任务成本 $5.46 已低于 Opus 5.5 max $5.98,旧版相关说法撤回;Argon 已 GA,旧受限观察撤回。价格表与榜单全部重核。 AA · Claude价格
02

历史原图与读图规则

本模块保留原网页的 7–8 月图像档案,用来解释斩杀线的来源;不是当前现价或当前榜单。历史素材的标题、模型版本和测评口径可能不同。当前选型看第 04–08 节(数据截至 10-23)。
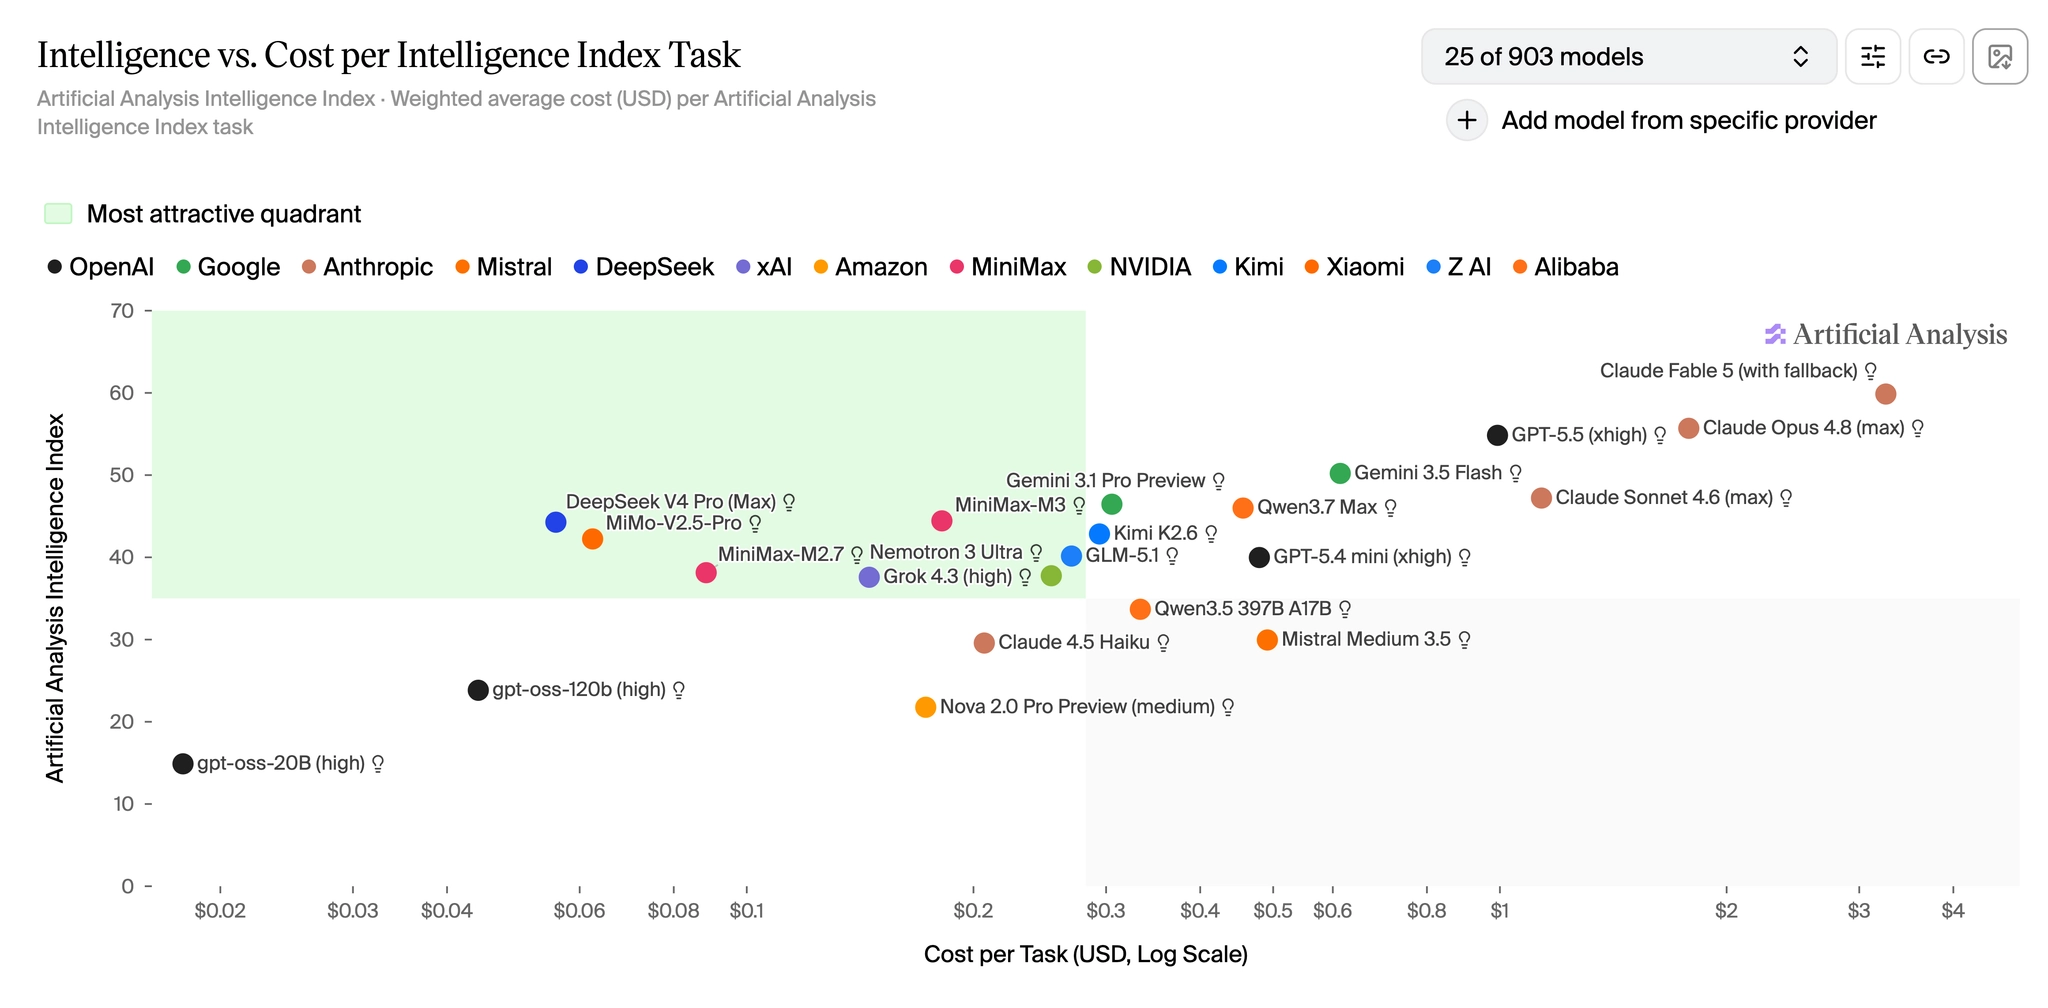
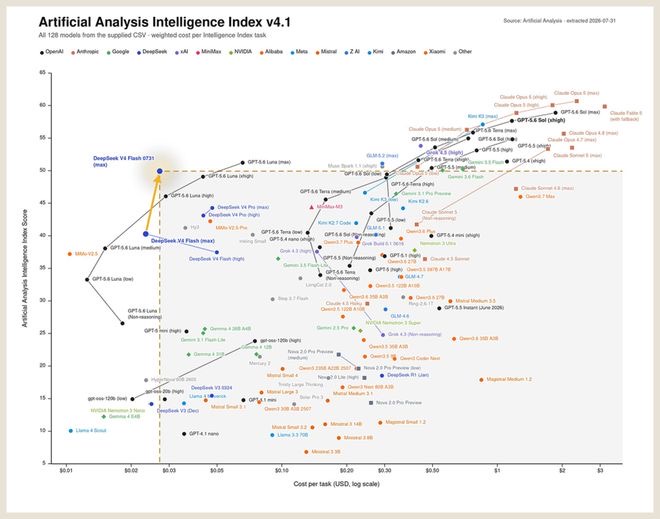
Artificial Analysis Intelligence Index v4.1 高清原图
高清原图 · Artificial Analysis Intelligence Index v4.1(2026-07-31 提取)· 网传斩杀线图的数据原型点击放大
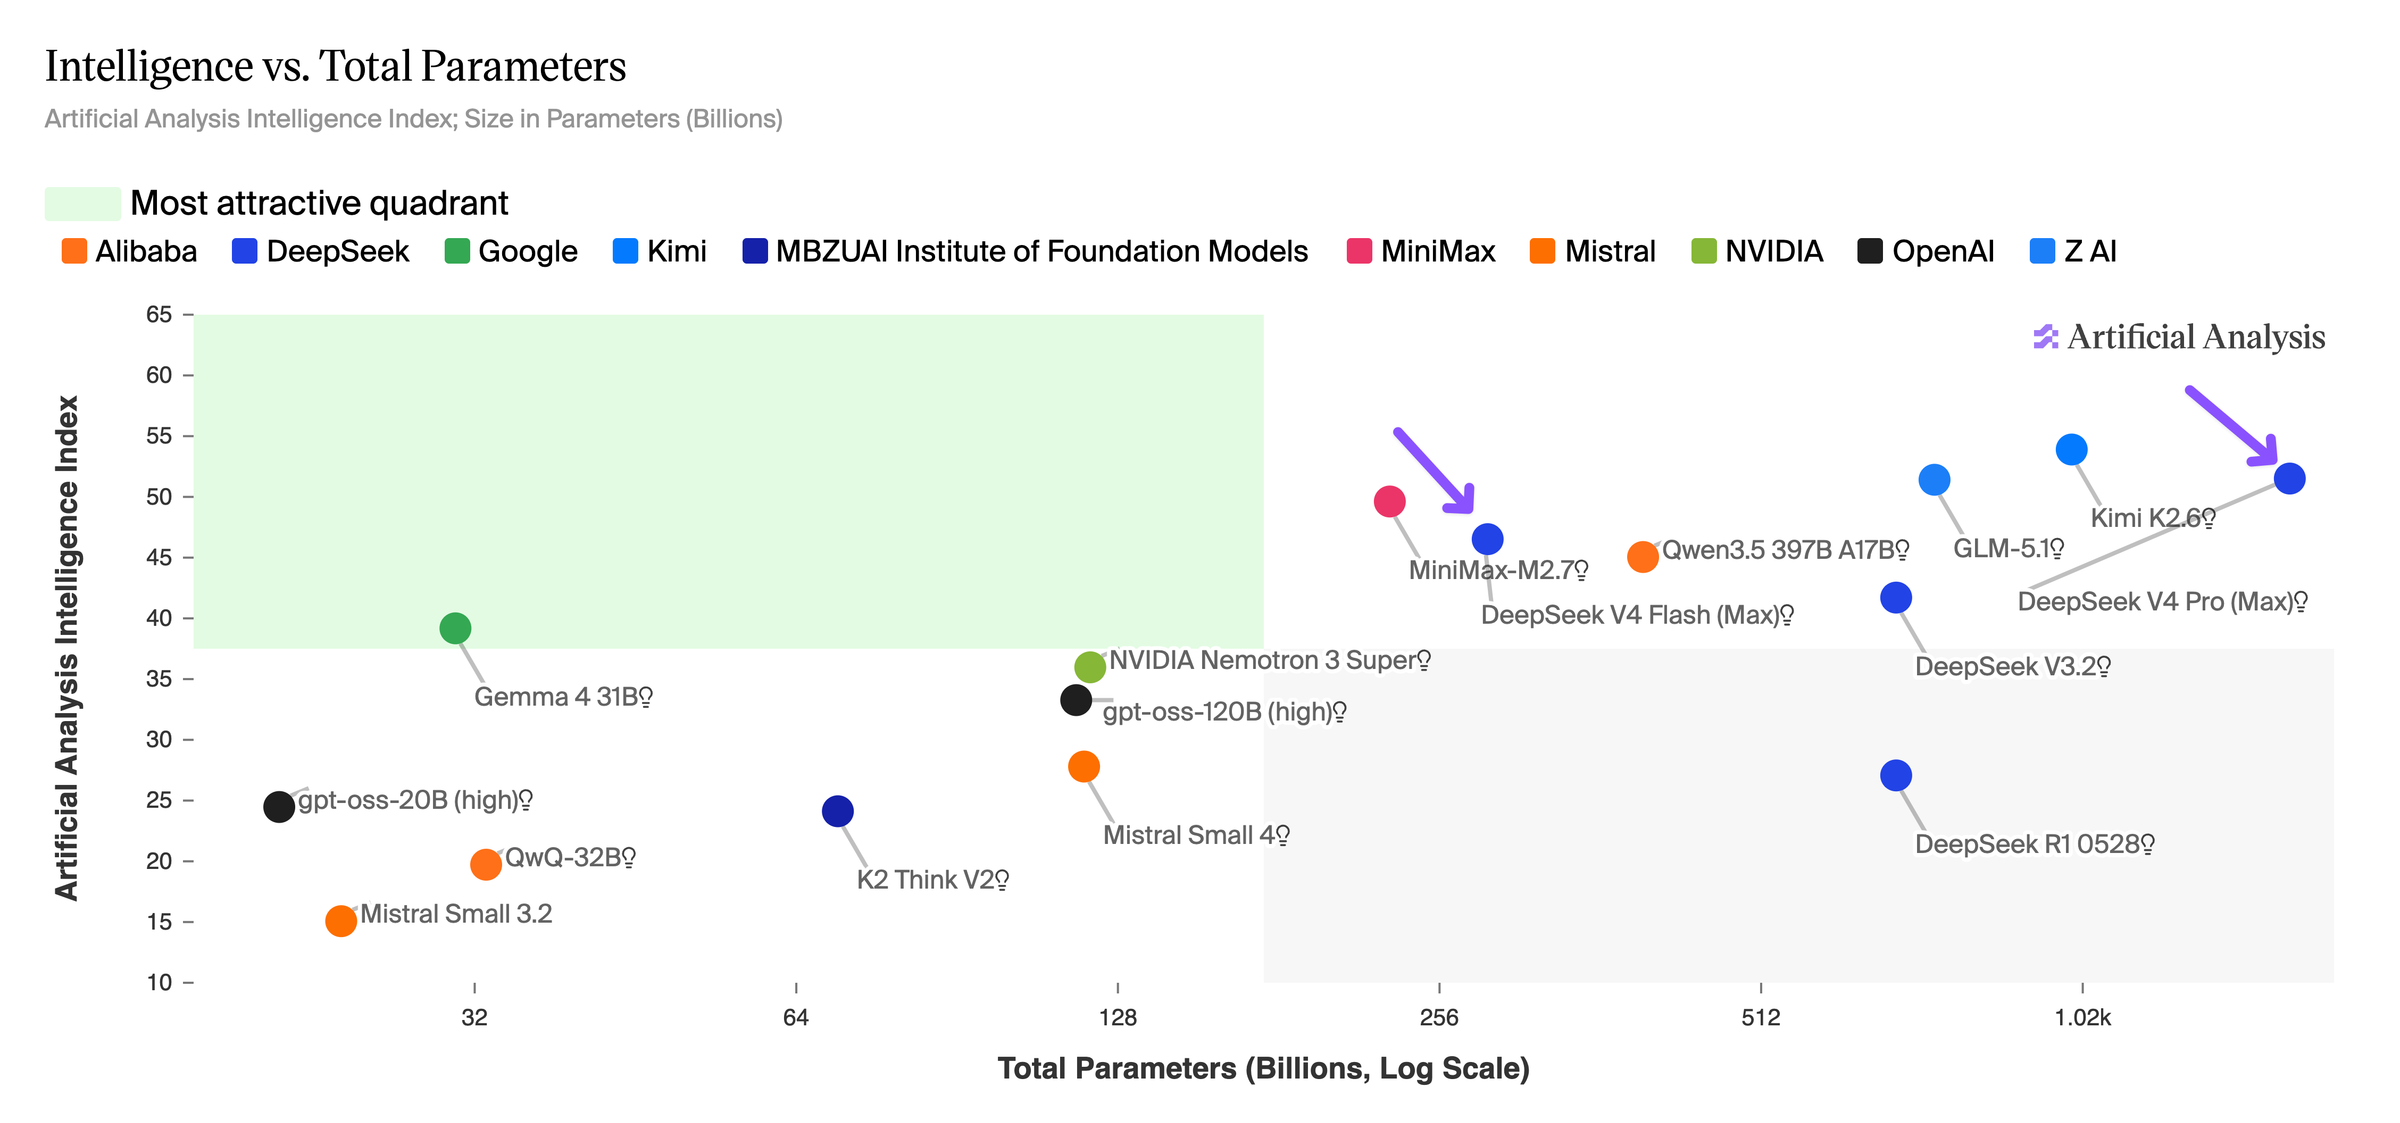
DeepSeek is back amongst the frontier 高清图
同系列精简版:「DeepSeek is back amongst the frontier」(2400×1123)点击放大
自媒体斩杀线示意图
自媒体 AI 示意图(低清存档)· 新浪新闻配图 2026-08-03 · 横轴「加权分」无出处
自媒体变体一
示意图变体 ①
自媒体变体二
示意图变体 ②(千问 3.8 Max 压线版)
自媒体变体三
示意图变体 ③(条形图版)
问题 01
先核对版本
模型同名不等于路由相同;high/max、fallback 和测试 harness 都影响结果。
问题 02
再核对计费入口
官网 API、套餐、第三方转发、促销价不是同一种价格,不能交叉套用。
问题 03
最后验证交付
综合分不能预测中文口播的语气,也不能代替代码运行。只把榜单当作缩小试用范围的工具。
03

历史坐标系:理解“斩杀”,不作为今日推荐

保留 08-13 前后的预测与实测示意,作为历史复盘。旧 SWE 分、AA 旧版本、旧价格不与 10-23 快照连线,也不代表模型能力随版本换分而退步。

能力 × 价格:08-13 调价前的历史落点
X: SWE-BENCH VERIFIED (%) | Y: OUTPUT PRICE $/M TOKENS (LOG) | 当前峰谷价见第 04 节价格表 | 绿色 = V4 PRO 正式版预测层
0.2 0.5 1 2 5 10 20 78 80 82 84 86 88 90 能力 →(SWE-bench Verified,%) 输出价格($/百万 tokens,对数) 经典斩杀区(红) 能力 ≤ V4 Flash 且更贵 真实数据下:空的 斩杀边界(过 V4 Flash) V4 Pro 正式版·预测斩杀区(绿) 若爆料成立:三旗舰 + GPT-5.5 全部进线,仅剩 Opus 级能力溢出 预测区间:能力 85–88 · 输出 $1.5–4 能力溢出区 贵,但有只有它们能做的事 国产三旗舰:能力 +0.8 ~ +1.7 分 调价前价格贵 6.1 – 13.7 倍 → 性价比被斩杀 DeepSeek V4 Flash 80.6 / $0.42 · 08-13 历史价 GLM-5.3 81.4 / $2.56 Kimi K3 81.5 / $4.00 千问 3.8 Max 82.3 / $5.76 GPT-5.5(约) ~85 / $8.00 Claude Opus 4.6(约) ~88 / $15.00 DeepSeek V4 Pro 正式版(预测) ~86.5 / ~$2.5 · 涨价后预估
斩杀线本体 GLM-5.3 Kimi K3 千问 3.8 Max 海外旗舰(官方口径约数) V4 Pro 正式版·预测斩杀区(绿)
反转点网传图里「V4 Flash 58 分、别人 50 分」的排布与公开基准不符:真实数据里三家国产新旗舰能力全部略高,但都站在红色斩杀边界的右上方——能力略高、价格贵一个数量级。被斩杀的是性价比,不是能力。注意:本图是调价前历史快照。
绿色叠层 · ✅ 08-13 已验证这是 08-08 基于灰度爆料与涨价公告的预测层(当时口径:能力 ~86.5 SWE / 输出 ~$2.5)。08-13 V4 Pro 正式版已发布:旧价实测斩杀位置为 AA 指数 58 分 / 每任务 $0.06(输出 $0.87/M)。8 月 17 日起调价,当前峰谷价见第 04 节价格表。
04

当前费率:报价之前,先核这张表

截至 2026-10-24(Kimi K3.1 Pro 官方价 10-24 已核;GLM 沿用 10-17 快照并标注)。下表为官方 API 刊例(美元 / 百万 tokens),不是套餐价,也不是 AA 每任务成本。DeepSeek 现页仍列 V4 Pro(谷 $0.66/$1.98,峰 $1.32/$3.96),且 deepseek-flash 已由 1017 版本服务;V4 Pro 不作为新项目默认。
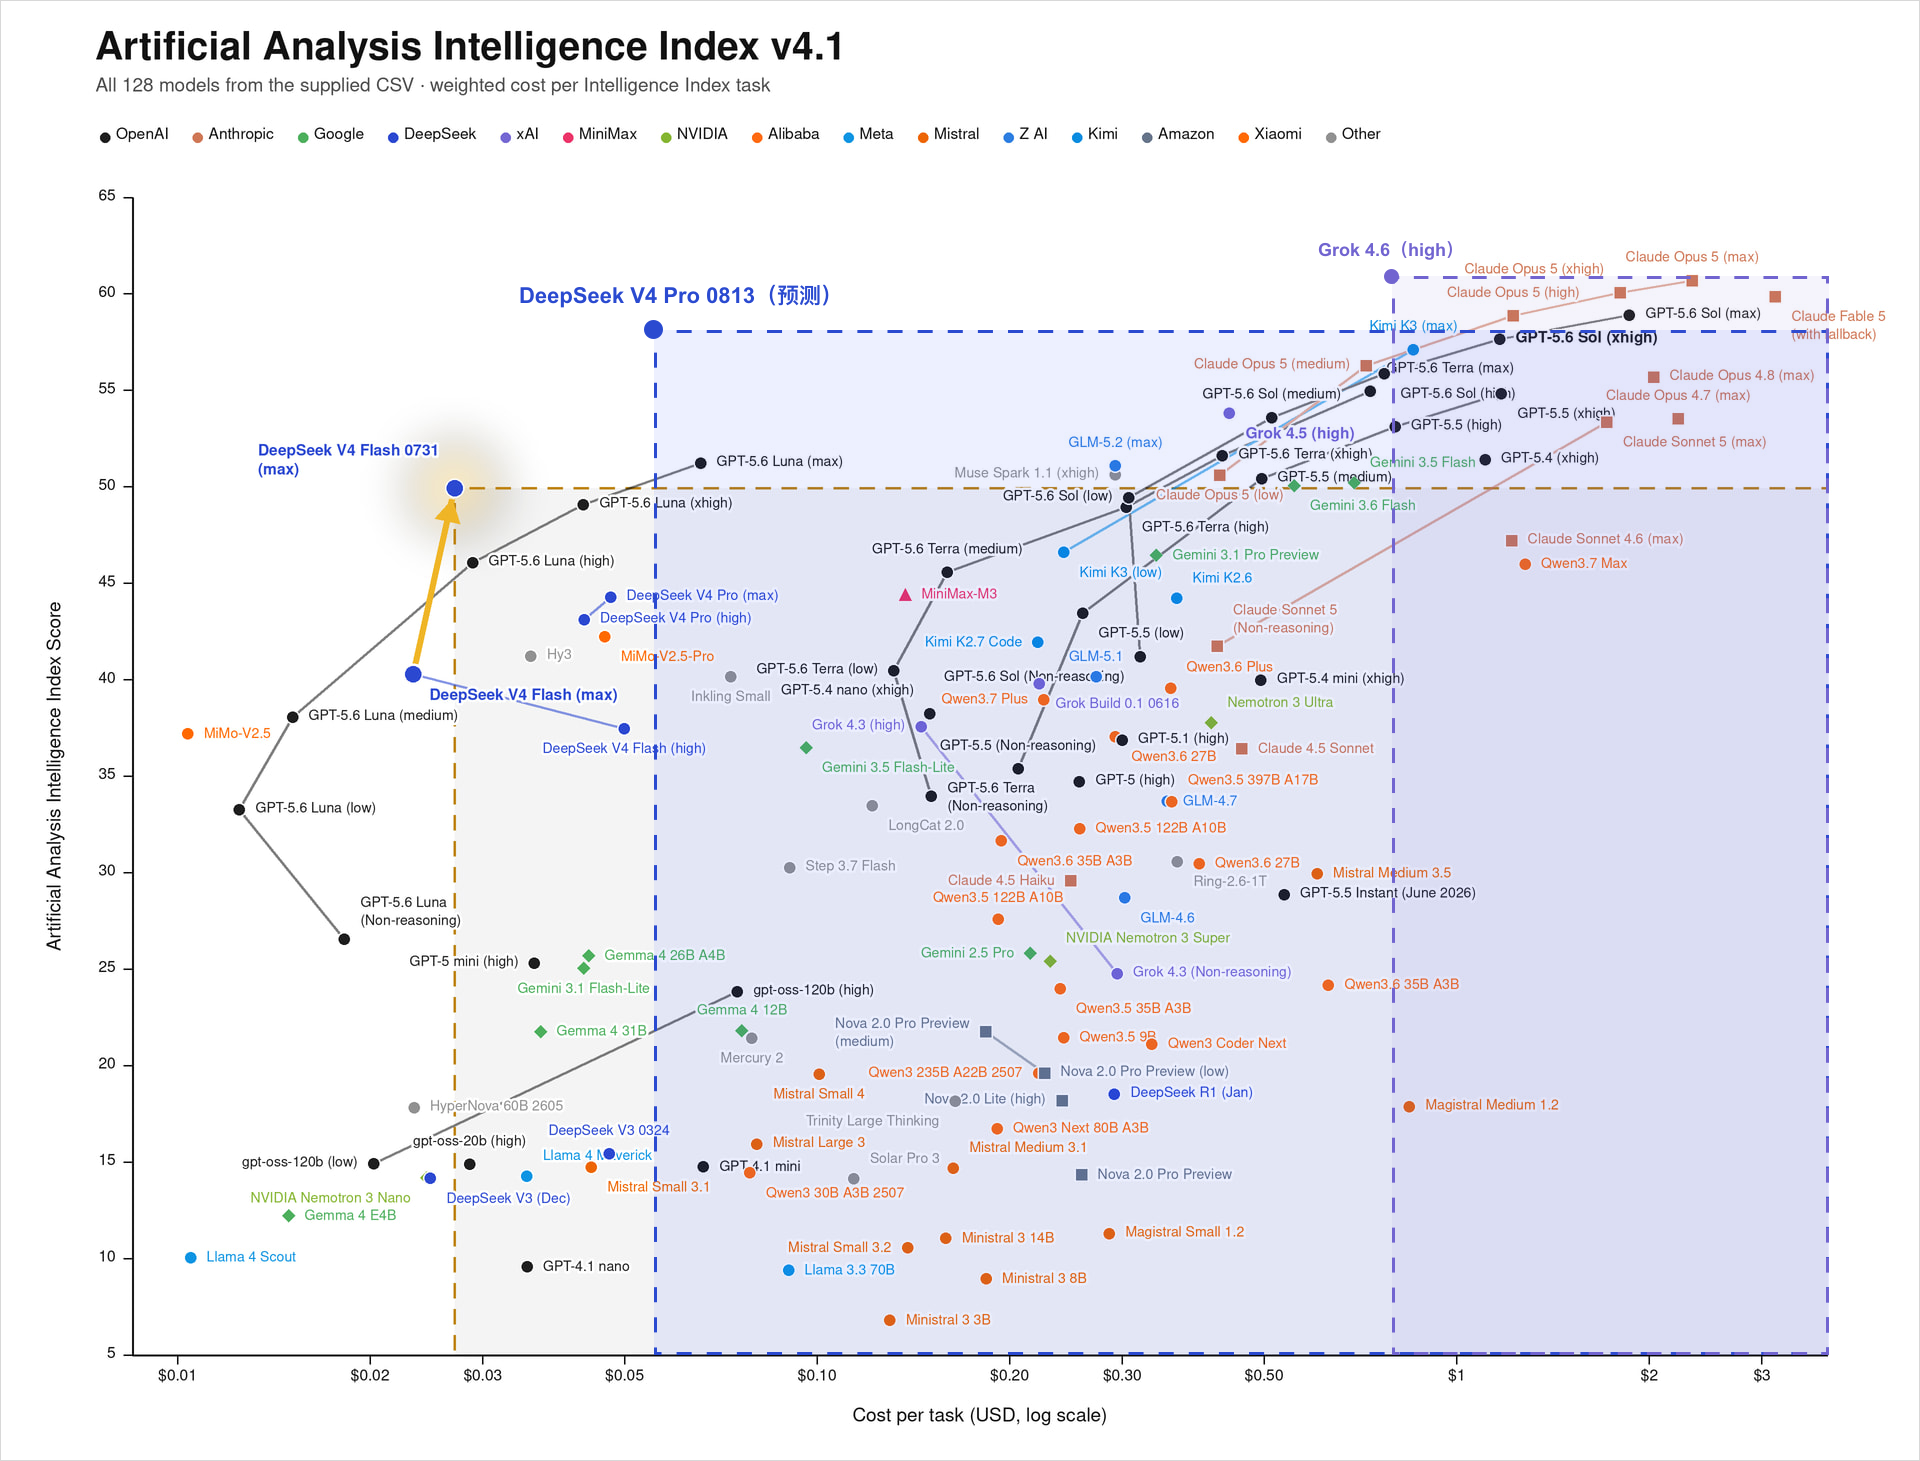
AA Intelligence Index v4.1 全量 128 模型散点(2026-08-13)
08-13 留档图:旧价格与旧评测版本,不能作为 10-02 选型依据。点击可放大。
模型 / 路由未命中输入命中输入输出使用条件 / 来源
Claude Haiku 5.5(≤100K)$0.1$0.01$0.5超过 100K 提示整次按 $0.50/$2.50
Haiku
GPT-6 Luna$0.1$0.01$0.5Standard,输入 ≤272K;缓存写入另计
Luna
MiMo V2.6 Flash$0.14$0.0028$0.28全年统一标价;多模态用量另看实际账单
MiMo Flash
GLM-5.3 Flash$0.15$0.03$0.5官方 10-17 快照现价;本轮官网暂未复核成功
GLM价格
DeepSeek V4.1 Flash · 谷$0.15$0.003$0.6工作日非高峰、周末及中国法定节假日;1017 版本服务
DeepSeek
DeepSeek V4.1 Flash · 峰$0.3$0.006$1.2工作日北京 09–12、14–18;不含中国法定节假日
DeepSeek
GLM-5.3 FlashX$0.37$0.075$1.25高价快速档;不自动替代 Flash
GLM价格
MiMo V2.6 Pro$0.435$0.0036$0.87官方 USD 刊例;人民币为输入 ¥3 / 输出 ¥6
MiMo Pro
Mistral Large 4 预览$0.68$0.07$2.09促销价,刊例 $1.36/$4.18;月末权重待落地
Mistral价格
GLM-5.3$1.4$0.26$4.4文本模型;套餐积分另按订阅规则
GLM价格
Grok 4.7(≤200K)$2$0.5$6超过 200K 提示有更高档;Fast 另计
Grok
GPT-6.1 Sol$2$0.1$10Standard,输入 ≤272K;Ultrafast 与长上下文另计
Sol
Claude Sonnet 5.5$2$0.1$1010-07 起缓存读降至 $0.10;缓存写入另计
Claude价格
Gemini 4 Argon(导入价)$2$0.1$10导入价到 11-30;之后 $4/$20
Google价格
Kimi K3.1 Pro$2$0.2$10官方国际 API;缓存写 5m $2 / 1h $4;1M 上下文
Kimi
Kimi K3.1 Pro Highspeed$4$0.2$20输出约 2–3 倍速;缓存写 $4/$8
Kimi
Kimi K3$3$0.3$15官方国际 API;不能拿套餐价套 API
Kimi
Muse Wonder$4$0.2$20仅 Standard 模式;Full 无公开 API 价
Muse价格
Claude Opus 5.5$4$0.2$20标准 API;Fast 输入/输出 $8/$40
Opus
08-13 历史快照 · 08-13 实测重画:九个关键落点(AA 口径)
X: COST PER TASK USD (LOG) | Y: AA INTELLIGENCE INDEX | 数据源:AA V4.1 全量 CSV(08-13)+ 官方定价
45 50 55 60 63 0.02 0.05 0.1 0.2 0.5 1 2 每任务成本 →(USD,对数刻度) AA 智能指数 → 新斩杀区(08-13 历史价):能力 ≤58 且每任务成本 ≥ $0.06 Kimi K3 (max) · GLM-5.3(暂无 AA 分,沿用 5.2 口径) · Grok 4.5 · Claude Opus 5 (medium) 全部进线 斩杀线抬升:50 → 58 分 能力溢出区(≥60) Grok 4.6 把入场价打到 $0.65 DeepSeek V4 Flash 0731 50 / $0.028 · 旧斩杀线 DeepSeek V4 Pro(正式版) 58 / $0.06 · 新斩杀线本体 GLM-5.3(暂无 AA 分,沿用 5.2 口径) 51 / $0.30 Kimi K3 (max) 57.5 / $0.55 · 压线被斩 Grok 4.5 (high) 52.5 / $0.45 Claude Opus 5 (medium) 55.5 / $0.42 · 首次进线 GPT-5.6 Sol (max) 59 / $1.50 · 仅 1 分豁免 Claude Opus 5 (max) 61 / $1.60 Grok 4.6 (high) 61 / $0.65 · 溢出区价格挑战者
旧斩杀线(Flash) 新斩杀线(V4 Pro) GLM-5.3 Kimi K3 Grok 4.6 Claude Opus 5 GPT-5.6 Sol
历史档案本图使用旧版 AA 与当时成本。只复盘当时竞争,不用于当前采购;今天的价格看上表,当前任务比较看第 06A 节。
08-13 历史快照 · 新口径性价比指数:AA 指数 ÷ 每任务成本(V4 Flash = 100,08-13 历史价快照)
V4 Flash 0731旧价 $0.028 / 50 分
100
V4 Pro旧价 $0.06 / 58 分
54.1
GLM-5.3(暂无 AA 分,沿用 5.2 口径)$0.30 / 51 分
9.5
Kimi K3 (max)$0.55 / 57.5 分
5.9
Grok 4.6 (high)$0.65 / 61 分
5.3
GPT-5.6 Sol (max)$1.50 / 59 分
2.2
Claude Opus 5 (max)$1.60 / 61 分
2.1
历史档案本图使用旧版 AA 与当时成本。只复盘当时竞争,不用于当前采购;今天的价格看上表,当前任务比较看第 06A 节。
05

性价比怎么比:先算同一笔账

先定义调用量,再比较账单。下面是假设每次 10,000 未缓存输入 + 2,000 计费输出、共 1,000 次的标准 API 成本;计费输出包含适用的推理 tokens。忽略工具、搜索、重试、税费和套餐,这不是模型完成同一任务所需的真实用量。

固定用量账单 · 越短越省同一输入输出量;不是能力除以单一输出价
MiMo V2.6 Flash10M 输入 + 2M 计费输出 / 1,000 次
$1.96
Claude Haiku 5.5(≤100K)10M 输入 + 2M 计费输出 / 1,000 次
$2
GPT-6 Luna10M 输入 + 2M 计费输出 / 1,000 次
$2
GLM-5.3 Flash10M 输入 + 2M 计费输出 / 1,000 次
$2.5
DeepSeek V4.1 Flash · 谷10M 输入 + 2M 计费输出 / 1,000 次
$2.7
DeepSeek V4.1 Flash · 峰10M 输入 + 2M 计费输出 / 1,000 次
$5.4
MiMo V2.6 Pro10M 输入 + 2M 计费输出 / 1,000 次
$6.09
GLM-5.3 FlashX10M 输入 + 2M 计费输出 / 1,000 次
$6.2
Mistral Large 4 预览10M 输入 + 2M 计费输出 / 1,000 次
$10.98
GLM-5.310M 输入 + 2M 计费输出 / 1,000 次
$22.8
Grok 4.7(≤200K)10M 输入 + 2M 计费输出 / 1,000 次
$32
GPT-6.1 Sol10M 输入 + 2M 计费输出 / 1,000 次
$40
Claude Sonnet 5.510M 输入 + 2M 计费输出 / 1,000 次
$40
Gemini 4 Argon(导入价)10M 输入 + 2M 计费输出 / 1,000 次
$40
Kimi K3.1 Pro10M 输入 + 2M 计费输出 / 1,000 次
$40
Kimi K310M 输入 + 2M 计费输出 / 1,000 次
$60
Muse Wonder10M 输入 + 2M 计费输出 / 1,000 次
$80
Claude Opus 5.510M 输入 + 2M 计费输出 / 1,000 次
$80
Kimi K3.1 Pro Highspeed10M 输入 + 2M 计费输出 / 1,000 次
$80
怎么用先用这张图估预算,再用 20 个真实任务量合格交付成本。Haiku 5.5 与 Luna 静态账单并列最低($2),MiMo Flash 更低($1.96);不能据此断言完成率相同。DeepSeek 遇缓存命中和可调度任务仍可能有优势。
缓存会改结论例如 DeepSeek 谷价在 90% 输入命中时,以上 1,000 次约 $1.377;GLM Flash 约 $1.42。Sonnet 5.5 缓存读 10-07 起降至 $0.10,高命中场景的账单明显低于表面刊例。仅限相同命中率与计费用量的估算,不承诺你的业务能达到。
05A

Flash 独立比较:便宜,要落到合格交付

DeepSeek V4.1 Flash 1017 vs GLM-5.3 Flash,扩展 Haiku 5.5、MiMo 与 Luna 作为备选。价格和独立评测分开讲,优先保留已经通过验收的流程。

10-23 官方价 · USD / MTok

DeepSeek V4.1 Flash 1017

缓存型、文本吞吐候选
输入 / 输出 $0.15 / $0.60(谷)

AA max 升至 45 分 / $0.26 task / 195 tok/s(10-23 快照)。保留重复材料、摘要、分类、长上下文缓存场景;峰价双倍,周末与中国法定节假日全天谷价。Search/Fetch 11-01 起各 $0.75/千次。

10-23 官方价 · USD / MTok

GLM-5.3 Flash

低价视觉与工具任务候选
输入 / 输出 $0.15 / $0.50

AA 42 分 / $0.28 task / 64 tok/s。已有 GLM 工作流可以继续;与 MiMo、Haiku 比的是合格交付率,不是更高分一定省钱。

没有历史包袱

先各试 Haiku 5.5、MiMo Flash 与 Luna,跑抽取/分类/格式化任务;验收通过再扩大流量。

已有缓存流水线

保留 V4.1 Flash 1017,拿实际缓存率重算;11-01 起把 Search/Fetch 计费计入 Agent 成本。

视觉与文件交付

比较 GLM Flash 与 MiMo,不把能看图等同于会生成合格 PPT;必须渲染、查公式。

高价值中文成稿

Flash 负责证据和初稿;Opus 4.6 / K3 保留,Opus 5.5 做同题挑战者。

便宜模型也要看能力档10-23 AA 当前快照;不同 effort 已写明
MiMo V2.6 ProAA 每任务 $0.13
46
DeepSeek V4.1 Flash 1017 maxAA 每任务 $0.26
45
Claude Haiku 5.5 maxAA 每任务 $0.21
43
GLM-5.3 FlashAA 每任务 $0.28
42
MiMo V2.6 FlashAA 每任务 $0.06
38
GPT-6 Luna maxAA 每任务 $0.07
38
注意DeepSeek 1017 把低价段能买到的能力抬到 45 分,吞吐 195 tok/s;Haiku 5.5 max 更快(235 tok/s)且有 Anthropic 工具生态。AA 任务成本包含评测用量,并非上图固定用量算式。 AA
实际任务默认试谁切换 / 保留条件
高频摘要、分类、JSONHaiku 5.5 / MiMo Flash / Luna抽检事实与结构;不合格才升级 Pro/Sol。
重复长材料与缓存DeepSeek V4.1 Flash 1017命中率高且交付合格就保留;不要为新模型破坏稳定缓存。
图片、音视频材料MiMo Pro/Flash;视觉已有链路用 GLM Flash逐页/逐段抽检数字与说话人;文字模型 GLM-5.3 不等于 GLM Flash。
多文件软件修改Sol medium → high;GLM-5.3 做现有链路对照同仓库、同工具权限、同测试集;失败记录必须可复现。
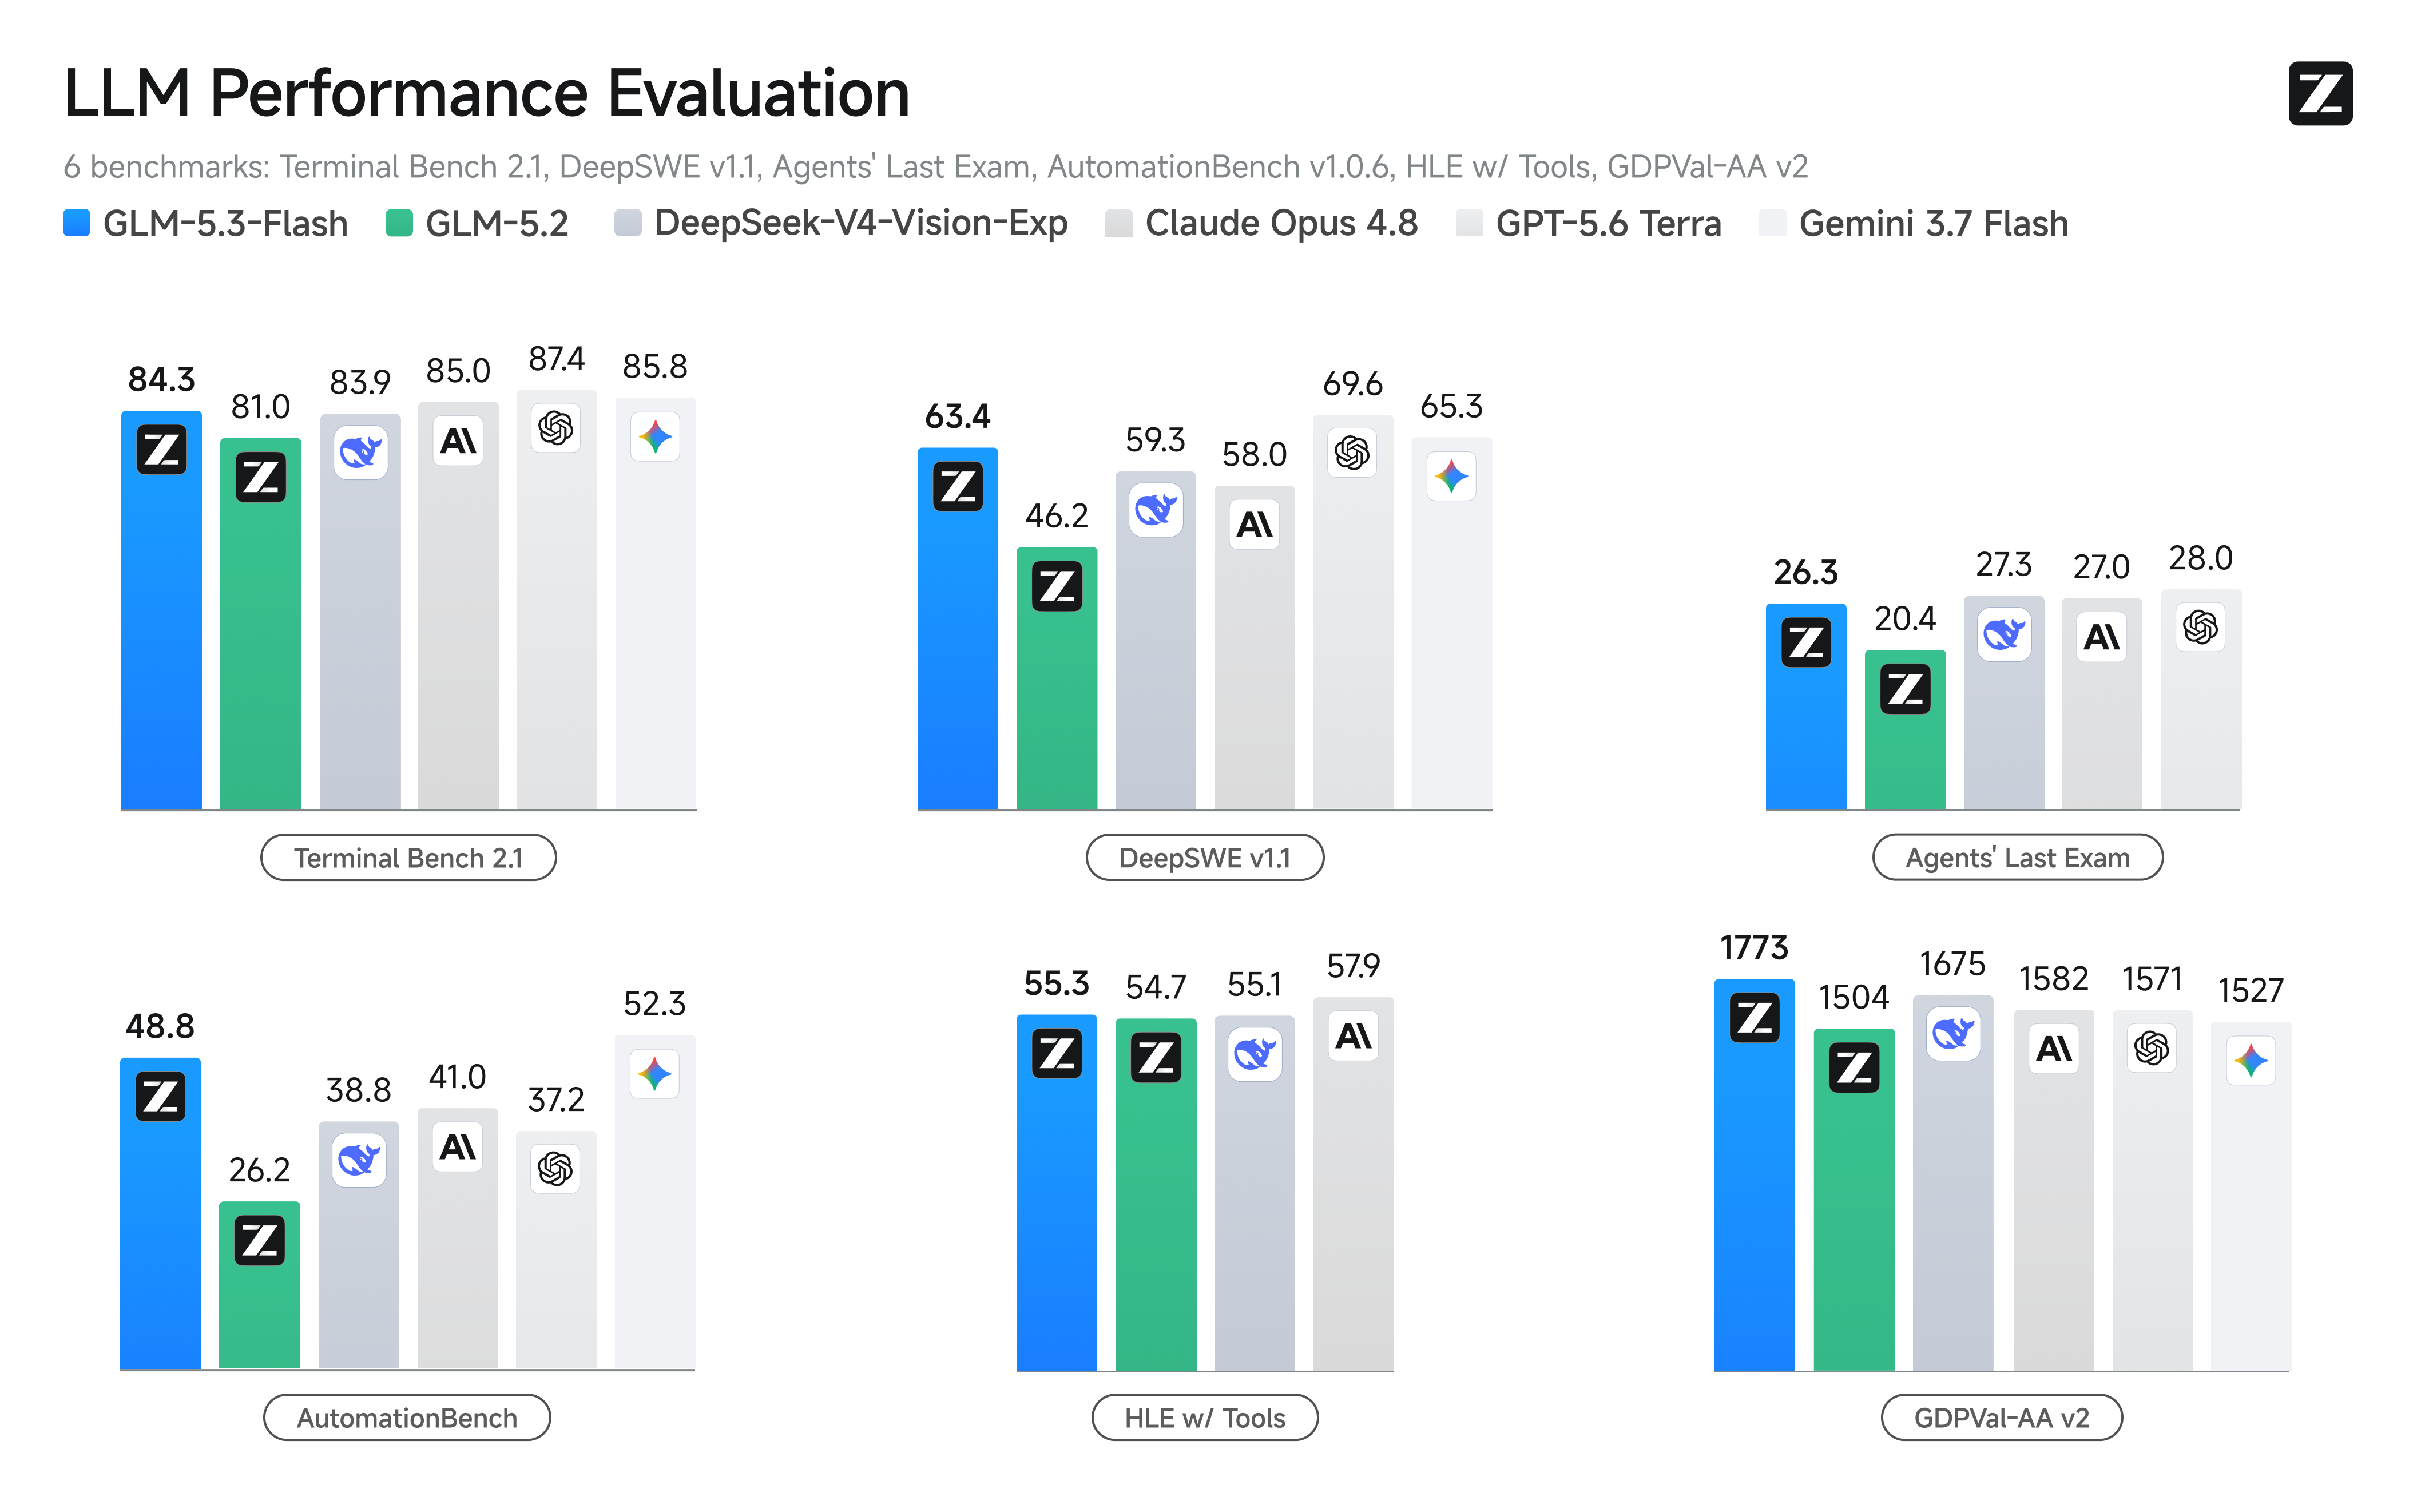
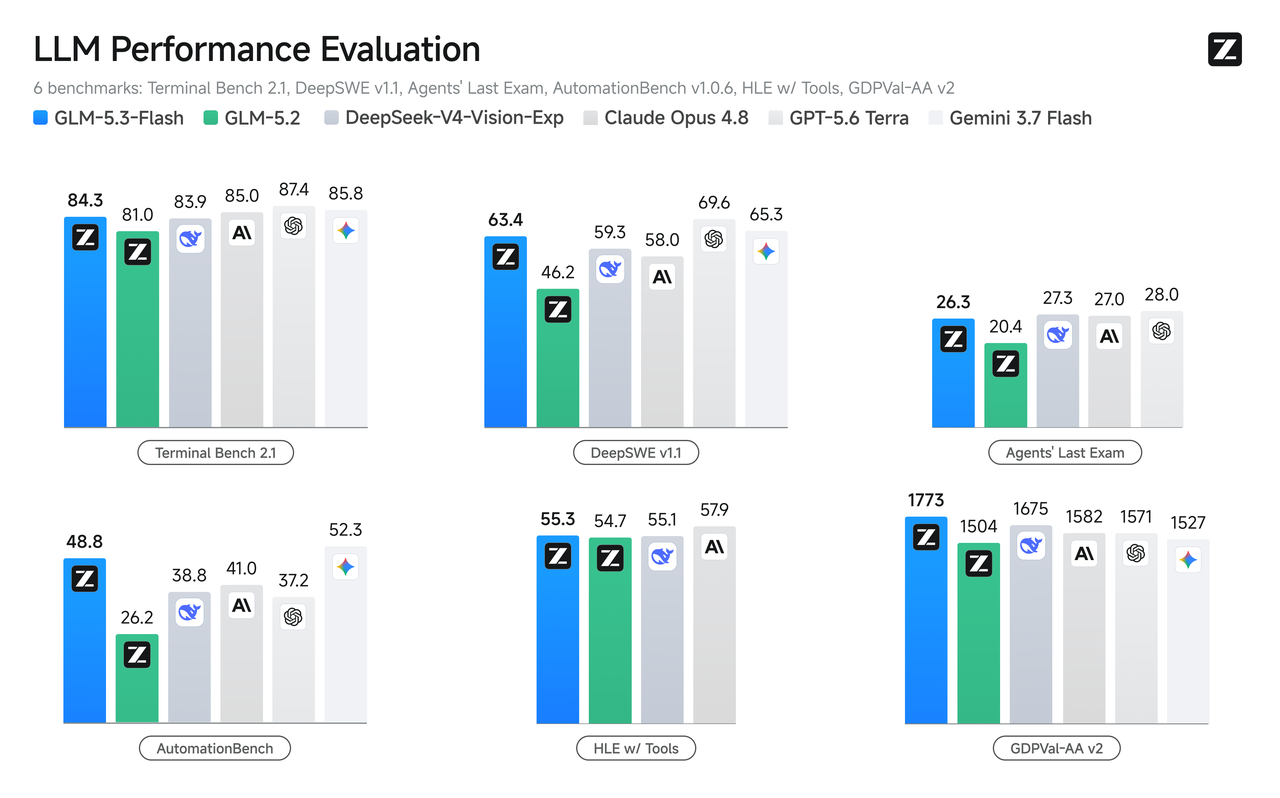
GLM-5.3 Flash 官方完整 benchmark 高清图
Z.ai 官方完整 benchmark 总图(4239×2643)· 厂商自报,适合看各任务结构,不与 DeepSeek 不同 harness 硬拼历史自报图 · 点击放大
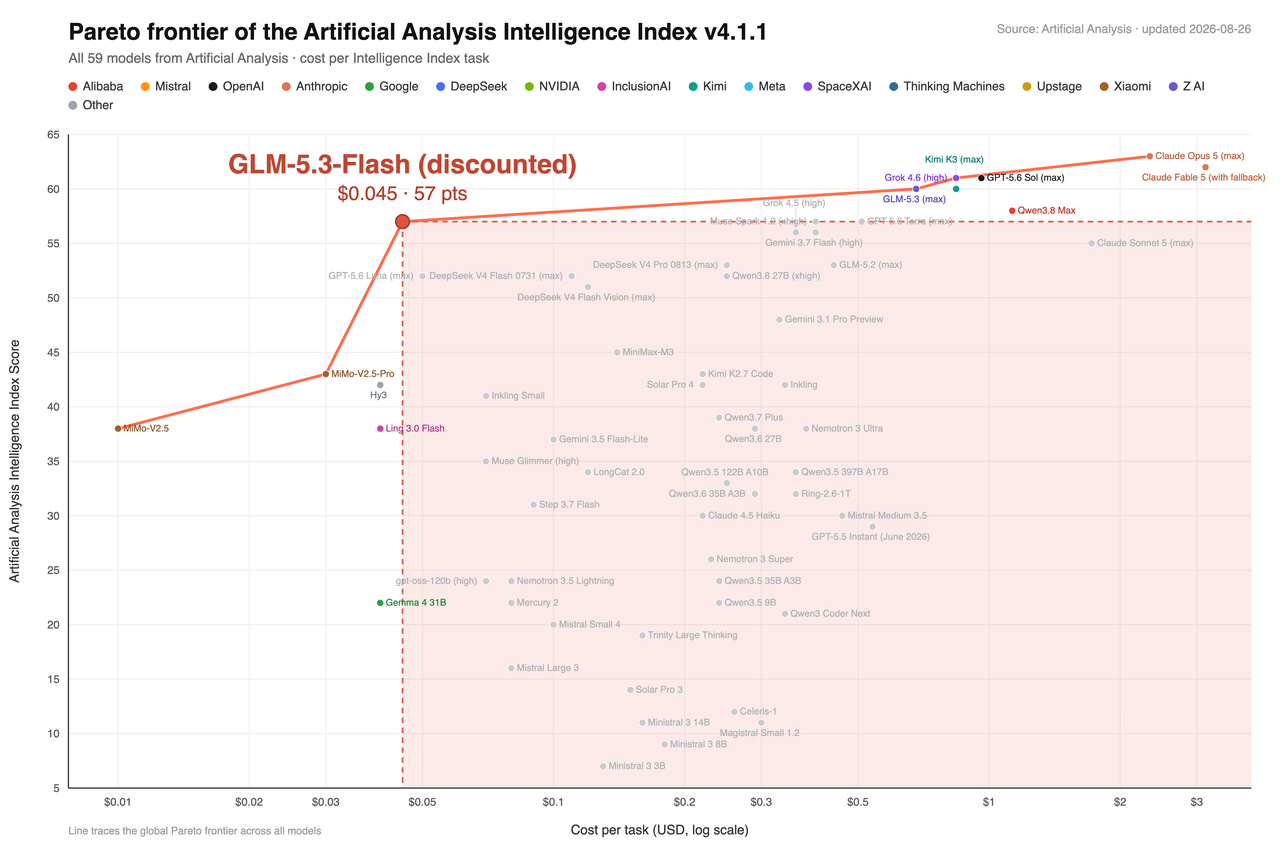
GLM-5.3 Flash Artificial Analysis 性价比前沿图
AA 性价比前沿 · $0.045/task 为当前促销口径历史自报图 · 点击放大
GLM-5.3 Flash 编程和 Agent benchmark 图
编程 / Agent 图 · Z.ai 自报,脚注含具体 harness历史自报图 · 点击放大
保留原图上面三图是 08-26 GLM 发布期素材,包含当时促销或厂商自报结果,保留用于复盘;不与当前 AA 表混算。

把便宜模型接进能验收的流水线

① 清洗 / 抽取Haiku / MiMo Flash / Luna;已有缓存用 DeepSeek。
→
② 生成 / 执行MiMo Pro / GLM / Sol 按任务升级,真实运行。
→
③ 复核 / 交付人审事实、数字、语气和客户验收标准。
内容服务

素材资产包

Flash 拆资料、按来源编号;人工选题,K3 或 Opus 写最终口播。

交付:事实卡 + 3 个开头 + 可拍逐字稿。
办公服务

每周经营简报

便宜模型抽取,Sonnet 制作文档表格,人查公式。

交付:可编辑文件 + 数据底稿 + 更新说明。
软件服务

小工具与后台

MiMo / GLM 写初版,Sol / Sonnet 修复杂问题,浏览器验收。

交付:可用地址 + 源码 + 测试记录。
核算

按合格件计价

记录 API、工具、重试与人工修改耗时;促销不写进长期利润承诺。

候选工作流,不是已验证收入案例。
06A

三周更新:先换候选,再换生产主力

以下是基于官方资料、AA 独立快照与公开小样本试用形成的选型建议,不是本项目的全模型实测。能力比较看明确档位;是否可用看官方入口;中文表达与真实交付必须再验收。

智能指数与实际常用档位AA 当前快照 10-24;Kimi K3 已由 K3.1 Pro 接替上榜,旧分 44 移出本图
Opus 5.5 max + fallback$5.98/task · 96 tok/s
58
Sonnet 5.5 max + fallback$5.46/task · 132 tok/s
56
Kimi K3.1 Pro$2.11/task · 77 tok/s
55
Gemini 4 Argon high$1.99/task · 76 tok/s
53
GPT-6 Astra max$3.26/task · 56 tok/s
53
Muse Wonder max$4.54/task · 144 tok/s
52
GPT-6.1 Sol max$0.72/task · 55 tok/s
52
GPT-6.1 Sol medium$0.21/task · 48 tok/s
48
Sonnet 5.5 high + fallback$0.88/task · 105 tok/s
47
Grok 4.7 high$2.73/task · 86 tok/s
46
MiMo V2.6 Pro$0.13/task · 54 tok/s
46
DeepSeek V4.1 Flash 1017 max$0.26/task · 195 tok/s
45
GLM-5.3 max$2.01/task · 78 tok/s
45
Claude Haiku 5.5 max$0.21/task · 235 tok/s
43
GLM-5.3 Flash$0.28/task · 64 tok/s
42
MiMo V2.6 Flash$0.06/task · 60 tok/s
38
GPT-6 Luna max$0.07/task · 136 tok/s
38
同一评测的每任务成本越短越便宜;不是你的业务完成率或账单承诺
Opus 5.5 max + fallback终稿 / 复杂判断
$5.98
Sonnet 5.5 max + fallback日常交付高档
$5.46
Kimi K3.1 Pro长稿 / Agent 新候选
$2.11
Gemini 4 Argon high复杂代码 / 创作新候选
$1.99
GPT-6 Astra max旗舰对照
$3.26
Muse Wonder max观察;Full 无公开 API 价
$4.54
GPT-6.1 Sol max复杂工程高性价比
$0.72
GPT-6.1 Sol medium日常 Agent 起步档
$0.21
Sonnet 5.5 high + fallback快速改稿 / 文档 / 修 bug
$0.88
Grok 4.7 highGrok Build / 研究候选
$2.73
MiMo V2.6 Pro低成本有验收任务
$0.13
DeepSeek V4.1 Flash 1017 max高缓存 / 快速文本吞吐
$0.26
GLM-5.3 max保留已跑通的编程链路
$2.01
Claude Haiku 5.5 max低价高速批量
$0.21
GLM-5.3 Flash现有低价视觉链路
$0.28
MiMo V2.6 Flash分类 / 草稿 / 原型
$0.06
GPT-6 Luna max低价任务;日常先低档
$0.07
为什么不用全员 maxOpus 5.5 max 在当前 AA 为 58 分 / $5.98;Sonnet 5.5 max 为 56 / $5.46——10-23 已比 Opus max 便宜,旧结论撤回,但两者都贵。Sol max 52 / $0.72、medium 48 / $0.21。先用够用档,验收失败再提高 effort;品牌便宜不等于每个档位都便宜。 AA
GPT-6.1 Sol已发布 · 工程首选
复杂代码 / 工具任务的默认候选
$2 入 / $10 出AA max 52 / $0.72medium 起步
  • 跨文件修改、调试、专业分析先试 medium;难题升级 high/max。 Sol
  • 同官方模型页,标准 Token 单价是 Astra 的 1/5;这是单价,不保证总任务成本 1/5。
  • 工具链若只支持 Chat Completions 工具调用,先检查 Responses 适配,不要盲改模型名。
  • 输入超过 272K 时整次请求触发更高费率;Ultrafast 是另一条计费轨道。
选用同任务与原主力 A/B,测试通过、人工接管更少才迁移。
Claude Opus 5.5已发布 · 写作挑战者
中文科技口播:挑战 Opus 4.6 的新候选
$4 入 / $20 出AA max 58 / high 54写作先 high 小样本
  • 官方强调更自然、更少术语;Every 的英文写作试用认可易读性与协作改善。 Opus · Every写作实测
  • 把你的最终定稿和事实卡交给它,测试论证、案例与口播节奏。
  • 英文可读性不能证明中文口播第一;该实测仍发现开头埋重点、重复铺垫。
  • 本轮没有对你的中文样本做付费实测,不承诺爆款,不立即淘汰 Opus 4.6。
选用Opus 4.6 vs Opus 5.5,一次只比这两个;K3 保留现有用途。
Claude Sonnet 5.5已发布 · 日常交付
日常文件交付与快速迭代候选
$2 入 / $10 出缓存读降至 $0.10默认 medium
  • 官方定位修 bug、文档、表格、幻灯片,适合客户改稿反复迭代。 Sonnet
  • 10-07 起缓存读降价,高命中改稿场景账单明显下降。 Claude价格
  • 高 effort 不一定经济;max $5.46/task 虽已低于 Opus max,仍是高价档。
  • 能调用工具不等于文件已合格,必须打开检查数字、格式和可编辑性。
选用先做周报、课程讲义或小功能修复;按实际合格件成本判断。
Claude Haiku 5.510-07 发布 · 低价高速
批量、快反、有自动验收的任务
≤100K $0.10/$0.50AA max 43 / 235 tok/s超过 100K 加价
  • 低价档里当前最快的一批;适合抽取、标签、分类、格式化初稿。 Haiku · AA
  • 与 Luna、MiMo Flash 同场试 20 个标准化任务,按合格件成本选。
  • 提示超过 100K 整次按 $0.50/$2.50 计费,长材料别塞给它。
  • 快不等于细:中文长稿、复杂推理仍交给高档模型。
选用程序校验 JSON、字段和事实来源;失败再升级 Sonnet/Sol。
Gemini 4 Argon10-13 正式开放
复杂代码 / 多模态新候选
导入价 $2/$10 至 11-30AA high 53 / $1.99之后 $4/$20
  • 已移出受限观察:AI Studio 与 API 可用,官方定位复杂代码、知识工作与创作。 Argon · Google价格
  • AA high 53 分 / $1.99,与 Astra max 同分但更便宜;值得进工程候选对比。
  • 导入价结束后价格翻倍;预算模型按 $4/$20 做压力测试。
  • 多模态预处理已有 Gemini 3.8 Flash / MiMo 链路的,不必立即迁。
选用拿到 API 后与 Sol 同仓库 A/B;按可合并结果决定。
Kimi K3.1 Pro10-24 发布 · 长稿 + Agent 挑战者
中文长稿、前端/3D 与工具任务的新候选
$2 入 / $10 出AA 55 / $2.111M 上下文
  • AA 全球第四,55 分 / $2.11 task;官方 TB 4.0 65.7%,接近 Opus 5.5 的 66.4%;GDPval-AA Elo 1846 第三。 Kimi · AA
  • 前端与 3D 创作为本次升级重点;Highspeed 输出约 2–3 倍速但价格翻倍。
  • 发布首日:独立小样本与中文口播实测都没有,不直接替换任何主力。
  • 官方自报基准只用于选候选;开放权重 11-04 前才落地。
选用新长稿任务与 Opus 5.5 同题盲测;工程与 Sol 同仓库 A/B。
替换与保留K3.1 Pro 进入长稿与 Agent 挑战位(发布首日,先试用不迁移);Haiku 5.5 进入低价高速候选;Argon 转正式候选;DeepSeek 1017 重回性价比前排;Muse Wonder / Full 进观察名单(Full 无公开 API 价);Mistral Large 4 等月末权重落地再评估私有化。K3、GLM、DeepSeek 已有合格流程继续保留,不强制追新。
06

七个主力位置,各自怎么用

主力名单按这次教学和业务需求调整:低价前排加入 Haiku 5.5 与 DeepSeek 1017,Argon 转正式候选,Muse / Mistral 进观察名单。老模型只有在你的验收任务上输掉,才真正退出生产。
Kimi K3 → K3.1 Pro保留 + 升级候选
长材料、前端方案与中文长稿对照
国际 API $3 / $15上下文 1MK3 已出 AA 榜K3.1 Pro AA 55
  • 你已有套餐且熟悉改稿流程,先延续有效用法;新长稿与前端/3D 任务试 K3.1 Pro($2/$10,比 K3 的 $3/$15 更低)。
  • 官方支持约 1M 上下文;当前国际 API 价格已核。 Kimi
  • 撤回旧版全场审美第一的断言;套餐性价比不能直接套 API 价。
  • K3 已不在 AA 当前榜单(由 K3.1 Pro 接替),旧分 44 仅作历史参考;赶时效的批量抽取交给便宜模型。
选用已有 K3 流程保留;新任务优先试 K3.1 Pro。
GLM-5.3保留 · 工程链路
适合已验证的文字代码与长任务
$1.4 入 / $4.4 出文本输入1M 上下文
  • 官方强调复杂编程、长任务后训练,已有 Coding Plan 用户可以继续。 GLM能力
  • 与 MiMo / Sol 在相同仓库做一次回归,对通过率和人工介入计时。
  • 旗舰 GLM-5.3 是文本模型,不要因 Flash 支持视觉就说旗舰能看图。
  • 订阅积分与模型系数以账户页为准;本轮官网价格页未复核成功,沿用 10-17 快照。
选用现有链路稳定就不急换;新项目同时试 MiMo Pro 与 Sol。
Qwen3.8 Max (0902)观察 · 企业场景
已有百炼接入与企业交付的对照
AA 45AA $5.41/task上下文 AA 984K
  • 已有企业流程、权限配置和采购体系,迁移成本可能高于模型差价。
  • 在当前 AA 快照中与 GLM max、DeepSeek 1017 同为 45 分,但任务成本最高;只用于候选筛选。 AA
  • 不标知识最准确、数学全场最强;综合分不能证明具体事实可靠。
  • 本轮未独立复核百炼地区/阶梯价,不写全场最低或直接套国际价。
选用保留有合同、有验收的企业链路;新项目先同任务对比。
DeepSeek V4.1 Flash 1017重回前排 · 缓存与吞吐
重复长资料、摘要与批量处理
谷 $0.15 / $0.60AA max 45 / 195 tok/s峰价双倍
  • 1017 版本把 AA max 从 39 抬到 45,与 GLM max、Qwen Max 同分,任务成本仅 $0.26。 AA · DeepSeek
  • 命中输入谷价 $0.003/M,稳定前缀缓存可能很有价值;谷峰调度仍有杠杆。
  • 11-01 起 Search/Fetch 各 $0.75/千次,Agent 经 Harness/Claude Code/Codex 的服务端调用不再免费。
  • 不得再用 0731 SWE 或旧 AA 分冒充 1017 能力;按实际账单和返工率比较。
选用高缓存旧链路继续;低价新项目把它与 Haiku、MiMo 同场对比。
Grok 4.7保留 · 新任务候选
带来源研究 / Grok Build 代码试用
标准起价 $2 / $6AA high 46Cursor / Build / API
  • 官方确认 Cursor、Grok Build、API 可用;对长任务和核验作了改进。 Grok
  • 研究工作保留原文链接与时间;有 X 搜索工具的入口适合补充争议点。
  • Grok 模型本身不等于默认接通 X;来源能力取决于你实际使用的工具。
  • 中文科技口播没有足够独立证据支持最强,不安排它直接替换熟悉写作模型。
选用研究材料和编程候选;研究结论必须回到原始资料核查。
MiMo V2.6 Pro / Flash主力低成本候选
低成本国产 Agent 与多模态候选
Pro $0.435 / $0.87Flash $0.14 / $0.28原生音视频输入
  • 官方已给可用 API、1M 上下文和明确价格。 MiMo Pro · MiMo Flash
  • AA Pro 46 / $0.13 task,Flash 38 / $0.06 task;复杂度不同,不要只看 Pro/Flash 名称。
  • 公开 DevOps 小样本中 Pro 的 K8s 运行成功仅 1/3,Flash 0/3,虽然静态校验通过。不能无人验收部署。 MiMo运行实测
  • Pro 吞吐约 54 tok/s;多模态和低价不等于写作、审美或实时任务都胜。
选用草稿试 Flash;多步任务试 Pro;所有可收费代码都要真实运行。
GPT-6 Luna保留 · 低价批量
低价标准化任务的选项
$0.10 入 / $0.50 出输入 ≤272KAA max 38 / $0.07
  • 适合抽取、标签、分类、格式化初稿;先 low/medium。 Luna
  • 09-25 修复过图像编码问题,旧截图工作流值得重新测一次。 OpenAI更新
  • Luna max 的 AA 分为 38,不能靠便宜推断能做复杂长 Agent。
  • max 的首段延迟在 AA 可超过一分钟;便宜不等于任何档位都快。
选用让程序校验 JSON、字段和事实来源;失败再升级 Sol。
低价前排:DeepSeek 1017、Haiku 5.5、MiMo 与 Luna 的 AA 分和任务成本
10-23 同口径快照重绘 · DeepSeek 1017 重回低价前排,并非宣称所有场景最优 · 点击放大
Agent 选型:模型之外,还要验收 harness
模型 + 工具 + 上下文 + 权限 + 恢复 + 验收,共同决定结果
先测四件事① 工具调用能否真实执行;② 长任务压缩后是否记得目标;③ 超时/中断能否恢复且不重复写入;④ 测试失败是否能定位并修复。让所有候选用同仓库、同提示、同预算和同工具权限。
别横比不同题Grok 发布页有 CursorBench、DeepSWE;Sonnet/Opus 发布页有 Terminal-Bench;旧 GLM 图中有 TB 2.1/3.0。版本与 harness 不同,不拼成谁编程第一。厂商自报只用于选候选。 Grok · Sonnet · GLM能力
实际接入Sol 6.1 工具需 Responses;MiMo 支持常见协议但仍要验证框架适配;Grok Build 是产品环境,不能将其结果等同于裸 API;DeepSeek Harness 的服务端 Search/Fetch 11-01 起计费,长跑 Agent 要把这笔钱计入预算。
模型中文科技口播编程 / Agent研究 / 多模态默认用法 / 何时升级
Opus 5.5新挑战者,先对 Opus 4.6 盲测复杂判断与复核候选证据齐备后的分析写作 high 小样本;不是默认全程 max
Sonnet 5.5日常改稿候选,不宣称文笔第一日常修 bug / 文件生成Office 交付候选medium 迭代;难题给 Opus / Sol
GPT-6.1 Sol事实结构、逻辑审查候选新工程默认候选之一工具辅助的专业分析medium 起步,失败再 high/max
Gemini 4 Argon无中文口播胜出证据正式开放,进工程候选多模态与知识工作导入价内完成 A/B;按 $4/$20 做预算压测
Claude Haiku 5.5标准化初稿简单、有自动验收的任务文本快速处理≤100K 提示;超长材料别用它
Kimi K3.1 Pro长稿新主力候选,与 Opus 5.5 同题盲测TB 4.0 65.7%;Agent 能力涨幅最大1M 长材料;前端/3D 创作新任务先试;K3 旧链路不强拆
Kimi K3保留已熟悉的长稿链路前端方案保留对照长材料整理已有套餐可留;API 批量慎用
GLM-5.3 / Flash材料处理为主5.3 工程;Flash 低价链路5.3 仅文本;Flash 视觉另测保留跑通流程,比较 MiMo 返工率
DeepSeek V4.1 Flash 1017摘要 / 事实卡 / 草稿适合有校验的分段任务视觉支持,音视频不混同看缓存率、峰谷调度与 11-01 后工具费
MiMo Pro / Flash抽取初稿;不保证细腻终稿Flash 原型;Pro 多步任务文本/图片/音频/视频所有可收费代码都要真实运行
Grok 4.7不作默认中文主笔Build / Cursor 场景试用有搜索工具时补 X 原始线索保留来源,不拿热帖当结论
GPT-6 Luna标准化低成本初稿简单、有自动验收的任务文本图片;09-25 修复后重测先 low/medium,不以 max 当低延迟
07

你的工作习惯,应该怎样保留与升级

不让榜单替你决定文风。留住经过人改、真实交付有效的模型;新模型每次只承担一个可验证的新角色。

实际问题
证据与边界
选用动作
K3 已有套餐好用,还要换吗?
套餐与 API 是两回事;K3.1 Pro API $2/$10 反而比 K3 的 $3/$15 低。
新任务试 K3.1 Pro;已有 K3 套餐流程保留
中文口播谁更没有 AI 味?
本轮查到 Opus 5.5 英文一手试用,不能直接外推中文平台爆款。
Opus 4.6 vs 5.5 同题盲测;K3 保留
Argon 现在能用了吗?
10-13 已 GA:AI Studio 与 API 可用,导入价 $2/$10 到 11-30。
导入价内完成与 Sol 的同仓库 A/B;预算按 $4/$20 压测
DeepSeek 1017 分涨了,要换回吗?
AA max 45 / $0.26 是评测口径;你的缓存率和峰谷调度才决定真实账单。
高缓存链路保留;新低价项目与 Haiku、MiMo 同场试
08

真正能落地的选用指南:从试用到收费交付

以下是可以执行的试用与产品化方案,不是本轮已完成的模型 A/B,也不是已验证的收入案例。重点是减少返工、缩短交付时间,让预算与真实结果对应。

中文科技 / AI 长口播

先把 Opus 5.5 放进同题盲测

选 3 个近期科技题,每题给同一事实卡、你的 2 篇定稿、相同目标字数。只跑 Opus 4.6 与 5.5,匿名交给你审;每题复跑一次。评分:事实 30、逻辑与案例 25、口语和人味 25、人工修改耗时 20。 K3.1 Pro 作为长稿第三对照,只在 Opus 盲测完成后再加进来。

发布验收:事实零硬伤、念得顺、没有空洞铺垫。5.5 多数胜出且修改时间更短再迁移;K3 作为已有长稿流程保留。
编程 Agent / 客户小系统

按可合并代码与可用地址验收

同一仓库的 10 个修复/功能任务,固定环境与权限。先 Sol medium、Sonnet medium 或现用 GLM;新候选试 Argon;低成本支线试 MiMo Pro 与 DeepSeek 1017;新候选加试 K3.1 Pro。记录通过率、重试次数、总 token 与人工接管分钟。

交付:部署地址、源码、运行测试、说明书。两个连续失败的修复轮次后升级模型或人工定位,不允许无限循环烧费。
知识服务 / 管理层简报

卖证据明确的判断和可编辑文件

Grok 有搜索工具时收集原始线索;Haiku/MiMo 抽取并保留来源;Sol/Opus 分析取舍;Sonnet 或已有工具生成报告、PPT、Excel。人检查引用、数字和公式。

报价结构:一次建库/模板费 + 每期更新费;不承诺保证收入。交付包含结论、反例、证据链接、待核项。
批量内容 / 多模态处理

每 100 个合格件记一次总账

纯文本先试 Haiku 5.5、MiMo Flash 或 Luna;已有高命中缓存用 DeepSeek 1017;视频/音频理解试 MiMo,已有高速链路留 Gemini 3.8。预留 20 个带标准答案的验收样本。

成本 = API + 搜索/工具 + 重试 + 人工修订。预算用正常刊例,促销和缓存节省作为余量;以合格件数作分母。
01

写清交付

先定客户能验收什么:成稿、文件、系统或数据。

02

小样本盲测

每次比较一个新候选;保持材料与任务一致。

03

小流量切换

先 10% 非关键任务;质量合格再扩大。

04

保留回退

记录模型版本和用量,失败回到旧的合格链路。

09

给学员的七条选型原则

适合课堂讲解,也适合作为团队采购和试用清单。

1
斩杀线是成本比较,不是淘汰宣判
只有在交付质量合格的前提下,便宜才有意义。综合榜分高不能保证中文稿好读或代码可运行。
2
今天先试哪些新模型
K3.1 Pro 试长稿与 Agent(发布首日,先小样本);Haiku 5.5 进低价高速候选;Argon 已 GA 进工程候选;DeepSeek 1017 重回低价前排;Opus 5.5 试高价值中文稿。
3
写作一次只比两个
保留 Opus 4.6 和你改过的样稿;本轮挑战者选 Opus 5.5。比事实、逻辑、口语和修改耗时,不能保证抖音或视频号爆款。
4
默认别全开 max
Opus max $5.98、Sonnet max $5.46 都是高价档(10-23 起 Sonnet max 已更便宜)。日常用合适档位,验收失败再升级。
5
新旧数据必须分开
7–8 月图片是历史档案;10-23 图表用同一当前快照。价格表区分输入、缓存、输出,不再拿旧分乘新价。
6
harness 要现场跑通
检查工具执行、长上下文压缩、异常恢复与真实验收;DeepSeek 服务端 Search/Fetch 11-01 起计费,长跑 Agent 预算要加这一项。
7
不追不可用或未核实的名字
Muse Wonder Full 只有订阅、无公开 API 价;Mistral Large 4 权重月末才落地;未核实的 GLM Prime、K4 等名称不作为现成主力。